EchoSparse:复用上一去噪步的统计量,用多级近似代替丢弃,并打包稀疏 attention 的计算 作者 EchoSparse Team
视频扩散模型的 self-attention 序列很长。以 Wan2.1-14B 生成 720p、81 帧视频为例,每层 attention 要处理约 7.56 万个 token。对一个 query 来说,很多 KV 块的贡献都很小。
LLM 上已有不少高稀疏度的做法,例如滑动窗口 attention(SWA),以及 GDN、KDA 这类线性 attention。这些做法基本都在训练时就写进了模型结构。本文讨论另一种情况:视频 DiT 已经用稠密 softmax attention 训练完成,我们不重新训练,直接替换它的 attention。视频里一个 query 的概率质量往往分散在时空方向的很多块上。每个块的质量都小,加起来的占比却不可忽略。直接丢掉这些块,softmax 的分子和分母都会改变,整行的加权方式也随之改变。不重新训练时,这种改变通常会在生成的画面上表现出来。在训练阶段就引入 SWA 或线性 attention 的视频模型属于另一类方法,本文不涉及。
我们的工作以两项已有方法为基础:Haopeng Li 等人的 PISA(论文 ,代码 ),以及 Sol-Attn(项目页 ,论文 )。两者对未选中的块都做近似计算。PISA 把每个块的处理从“保留或丢弃”改为“精确计算或近似”:重要的块精确计算,其余块用块内 Taylor 展开近似。Sol-Attn 给未选中的块加零阶补偿,并用一张 query token 对池化 key 块的 score tile 选择块。两种方法的补偿项都计入 attention 的分子和分母,多个块的代表向量也都已经拼在一起做 GEMM。
EchoSparse 在此基础上做了三项改动:
复用上一步的统计量。 相邻两个去噪步之间,每个 attention 行的统计量变化很小。因此上一步的 LSE(log-sum-exp,即 softmax 分母的对数)和每个块的质量(block mass,即一个块分到的 attention 概率之和)可以直接用在本步。FlashAttention 的内循环在每个 KV tile 上都要做三项计算:行最大值归约、缩放系数计算和旧累积量的重缩放。把 LSE 用作 softmax 的固定偏移后,这三项都可以去掉。块质量则给出块之间的相对重要性。多层级代表块。 一个块用多少个代表参与计算(记为 m b m_b m b 代表块的打包(packing)。 代表项的计算很零碎,例如 ( B q × d ) ( d × 1 ) (B_q\times d)(d\times1) ( B q × d ) ( d × 1 ) ( B q × d ) ( d × 1 ) (B_q\times d)(d\times1) ( B q × d ) ( d × 1 ) ( B q × d ) ( d × 4 ) (B_q\times d)(d\times4) ( B q × d ) ( d × 4 ) ( B q × d ) ( d × [ 1 + 1 + 4 ] ) (B_q\times d)(d\times[1+1+4]) ( B q × d ) ( d × [ 1 + 1 + 4 ])
代码:W2GenAI-Lab/EchoSparse-Attn
MP4 原版演示(早期实验) 1. 处理一个 KV 块的几种方式(基线方法 PISA)
记全序列长度为 N N N d d d d v d_v d v B q B_q B q B k B_k B k b b b m b m_b m b B q = 128 B_q=128 B q = 128 B k = 64 B_k=64 B k = 64 d = d v = 128 d=d_v=128 d = d v = 128 Q ∈ R B q × d Q\in\mathbb R^{B_q\times d} Q ∈ R B q × d K b ∈ R B k × d K_b\in\mathbb R^{B_k\times d} K b ∈ R B k × d V b ∈ R B k × d v V_b\in\mathbb R^{B_k\times d_v} V b ∈ R B k × d v
S b = Q K b ⊤ d ∈ R B q × B k , P b = exp ( S b − c 1 ⊤ ) , N + = P b V b , D + = P b 1.
S_b=\frac{QK_b^\top}{\sqrt d}\in\mathbb R^{B_q\times B_k},\qquad
P_b=\exp\bigl(S_b-c\,\mathbf 1^\top\bigr),\qquad
\mathcal N\mathrel{+}=P_bV_b,\qquad
\mathcal D\mathrel{+}=P_b\mathbf 1 .
S b = d Q K b ⊤ ∈ R B q × B k , P b = exp ( S b − c 1 ⊤ ) , N + = P b V b , D + = P b 1 . 其中 c ∈ R B q c\in\mathbb R^{B_q} c ∈ R B q N ∈ R B q × d v \mathcal N\in\mathbb R^{B_q\times d_v} N ∈ R B q × d v D ∈ R B q \mathcal D\in\mathbb R^{B_q} D ∈ R B q O = d i a g ( D ) − 1 N O=\mathrm{diag}(\mathcal D)^{-1}\mathcal N O = diag ( D ) − 1 N
下文用 ( B q × d ) ( d × B k ) ( B k × d v ) (B_q\times d)(d\times B_k)(B_k\times d_v) ( B q × d ) ( d × B k ) ( B k × d v )
精确计算(exact) :( B q × d ) ( d × B k ) (B_q\times d)(d\times B_k) ( B q × d ) ( d × B k ) B q B k B_qB_k B q B k B q B k B_qB_k B q B k ( B q × B k ) ( B k × d v ) (B_q\times B_k)(B_k\times d_v) ( B q × B k ) ( B k × d v ) B k ( d + d v ) B_k(d+d_v) B k ( d + d v ) 2 B q B k ( d + d v ) 2B_qB_k(d+d_v) 2 B q B k ( d + d v ) 丢弃(drop) :SWA 和块稀疏方法中落选的块属于这一类,相当于 B k → 0 B_k\to0 B k → 0 N \mathcal N N D \mathcal D D 一个代表 :( B q × d ) ( d × 1 ) (B_q\times d)(d\times1) ( B q × d ) ( d × 1 ) ( B q × 1 ) ( 1 × d v ) (B_q\times1)(1\times d_v) ( B q × 1 ) ( 1 × d v ) d + d v d+d_v d + d v 2 B q ( d + d v ) 2B_q(d+d_v) 2 B q ( d + d v ) 1 / B k 1/B_k 1/ B k
零阶近似与 token 数
取一行 query q q q n b n_b n b n b = B k n_b=B_k n b = B k
k ˉ = 1 n b ∑ j k j , v ˉ = 1 n b ∑ j v j , s ˉ = q ⊤ k ˉ d , δ j = q ⊤ ( k j − k ˉ ) d .
\bar k=\frac1{n_b}\sum_{j}k_j,\qquad \bar v=\frac1{n_b}\sum_j v_j,\qquad
\bar s=\frac{q^\top\bar k}{\sqrt d},\qquad
\delta_j=\frac{q^\top(k_j-\bar k)}{\sqrt d}.
k ˉ = n b 1 j ∑ k j , v ˉ = n b 1 j ∑ v j , s ˉ = d q ⊤ k ˉ , δ j = d q ⊤ ( k j − k ˉ ) . 则 s j = s ˉ + δ j s_j=\bar s+\delta_j s j = s ˉ + δ j ∑ j δ j = 0 \sum_j\delta_j=0 ∑ j δ j = 0
∑ j e s j = e s ˉ ∑ j e δ j , ∑ j e s j v j = e s ˉ ∑ j e δ j v j .
\sum_j e^{s_j}=e^{\bar s}\sum_j e^{\delta_j},\qquad
\sum_j e^{s_j}v_j=e^{\bar s}\sum_j e^{\delta_j}v_j .
j ∑ e s j = e s ˉ j ∑ e δ j , j ∑ e s j v j = e s ˉ j ∑ e δ j v j . 零阶近似取 e δ j ≈ 1 e^{\delta_j}\approx1 e δ j ≈ 1
D b ( 0 ) = n b e s ˉ = e s ˉ + ln n b , N b ( 0 ) = e s ˉ ∑ j v j = n b e s ˉ v ˉ .
\mathcal D_b^{(0)}=n_b\,e^{\bar s}=e^{\bar s+\ln n_b},\qquad
\mathcal N_b^{(0)}=e^{\bar s}\sum_j v_j=n_b\,e^{\bar s}\,\bar v .
D b ( 0 ) = n b e s ˉ = e s ˉ + l n n b , N b ( 0 ) = e s ˉ j ∑ v j = n b e s ˉ v ˉ . 因此一个代表由三项组成:( k ˉ , v ˉ , n b ) (\bar k,\bar v,n_b) ( k ˉ , v ˉ , n b ) n b n_b n b s ˉ + ln n b \bar s+\ln n_b s ˉ + ln n b exp 2 \exp_2 exp 2 log 2 n b \log_2 n_b log 2 n b log 2 64 = 6 \log_2 64=6 log 2 64 = 6 ln 64 ≈ 4.16 \ln 64\approx4.16 ln 64 ≈ 4.16
一阶与二阶近似
继续展开 e δ = 1 + δ + 1 2 δ 2 + ⋯ e^{\delta}=1+\delta+\tfrac12\delta^2+\cdots e δ = 1 + δ + 2 1 δ 2 + ⋯ ∑ j δ j = 0 \sum_j\delta_j=0 ∑ j δ j = 0
∑ j δ j v j = H ⊤ q d , H = ∑ j ( k j − k ˉ ) v j ⊤ ∈ R d × d v ,
\sum_j\delta_j v_j=\frac{H^\top q}{\sqrt d},\qquad
H=\sum_j (k_j-\bar k)\,v_j^\top\in\mathbb R^{d\times d_v},
j ∑ δ j v j = d H ⊤ q , H = j ∑ ( k j − k ˉ ) v j ⊤ ∈ R d × d v , N b ( 1 ) = e s ˉ ( ∑ j v j + H ⊤ q d ) , D b ( 1 ) = n b e s ˉ .
\mathcal N_b^{(1)}=e^{\bar s}\Bigl(\sum_j v_j+\frac{H^\top q}{\sqrt d}\Bigr),\qquad \mathcal D_b^{(1)}=n_b\,e^{\bar s}.
N b ( 1 ) = e s ˉ ( j ∑ v j + d H ⊤ q ) , D b ( 1 ) = n b e s ˉ . H H H
C = ∑ j ( k j − k ˉ ) ( k j − k ˉ ) ⊤ ∈ R d × d , T = ∑ j ( k j − k ˉ ) ⊗ ( k j − k ˉ ) ⊗ v j ∈ R d × d × d v ,
C=\sum_j (k_j-\bar k)(k_j-\bar k)^\top\in\mathbb R^{d\times d},\qquad
T=\sum_j (k_j-\bar k)\otimes(k_j-\bar k)\otimes v_j\in\mathbb R^{d\times d\times d_v},
C = j ∑ ( k j − k ˉ ) ( k j − k ˉ ) ⊤ ∈ R d × d , T = j ∑ ( k j − k ˉ ) ⊗ ( k j − k ˉ ) ⊗ v j ∈ R d × d × d v , D b ( 2 ) = e s ˉ ( n b + q ⊤ C q 2 d ) , N b ( 2 ) = N b ( 1 ) + e s ˉ 2 d T ( q , q , ⋅ ) .
\mathcal D_b^{(2)}=e^{\bar s}\Bigl(n_b+\frac{q^\top Cq}{2d}\Bigr),\qquad
\mathcal N_b^{(2)}=\mathcal N_b^{(1)}+\frac{e^{\bar s}}{2d}\,T(q,q,\cdot).
D b ( 2 ) = e s ˉ ( n b + 2 d q ⊤ C q ) , N b ( 2 ) = N b ( 1 ) + 2 d e s ˉ T ( q , q , ⋅ ) . 如果为每个块显式缓存这些矩(B k = 64 B_k=64 B k = 64 d = d v = 128 d=d_v=128 d = d v = 128
每块保存的量
元素数
数值
每个 query 的计算量
原始 K b , V b K_b,V_b K b , V b
B k ( d + d v ) B_k(d+d_v) B k ( d + d v ) 16,384
O ( B k ( d + d v ) ) O(B_k(d+d_v)) O ( B k ( d + d v ))
零阶 k ˉ , v ˉ , n b \bar k,\bar v,n_b k ˉ , v ˉ , n b
d + d v + 1 d+d_v+1 d + d v + 1 257
O ( d + d v ) O(d+d_v) O ( d + d v )
一阶 H H H
d d v dd_v d d v 16,384
O ( d d v ) O(dd_v) O ( d d v )
二阶 C , T C,T C , T
d 2 + d 2 d v d^2+d^2d_v d 2 + d 2 d v 2,113,536
O ( d 2 d v ) O(d^2d_v) O ( d 2 d v )
在这个形状下,d d v = 128 × 128 = B k ( d + d v ) = 64 × 256 dd_v=128\times128=B_k(d+d_v)=64\times256 d d v = 128 × 128 = B k ( d + d v ) = 64 × 256 ( B q × d ) ( d × d v ) (B_q\times d)(d\times d_v) ( B q × d ) ( d × d v ) T T T d 2 d v = 2,097,152 d^2d_v=2{,}097{,}152 d 2 d v = 2 , 097 , 152 d ( d + 1 ) d v / 2 ≈ 106 d(d+1)d_v/2\approx106 d ( d + 1 ) d v /2 ≈ 106
PISA 实际采用的是逐块零阶加全局一阶 。记 U \mathcal U U ∑ b ∈ U e s ˉ b H b ⊤ q / d \sum_{b\in\mathcal U} e^{\bar s_b}H_b^\top q/\sqrt d ∑ b ∈ U e s ˉ b H b ⊤ q / d ( ∑ b ∈ U e s ˉ b ) H ˉ ⊤ q / d \bigl(\sum_{b\in\mathcal U} e^{\bar s_b}\bigr)\bar H^\top q/\sqrt d ( ∑ b ∈ U e s ˉ b ) H ˉ ⊤ q / d U \mathcal U U H ˉ \bar H H ˉ U \mathcal U U H ˉ \bar H H ˉ H b H_b H b H b H_b H b
EchoSparse 保持零阶近似,把一个块分成更多组,组数 m b m_b m b
2. 复用上一步的 LSE
FlashAttention 类 kernel 按 KV tile 依次扫描,用 online softmax 维护每行的运行最大值。实现中统一使用 exp 2 \exp_2 exp 2 s i j s_{ij} s ij log 2 e \log_2 e log 2 e i i i
m i new = max ( m i , max j s i j ) , α i = 2 m i − m i new , p i j = 2 s i j − m i new , ℓ i ← α i ℓ i + ∑ j p i j , O i ← α i O i + ∑ j p i j v j .
\begin{aligned}
m_i^{\text{new}}&=\max\bigl(m_i,\ \max_j s_{ij}\bigr),\qquad
\alpha_i=2^{\,m_i-m_i^{\text{new}}},\qquad
p_{ij}=2^{\,s_{ij}-m_i^{\text{new}}},\\
\ell_i&\leftarrow\alpha_i\,\ell_i+\sum_j p_{ij},\qquad
O_i\leftarrow\alpha_i\,O_i+\sum_j p_{ij}v_j .
\end{aligned}
m i new ℓ i = max ( m i , j max s ij ) , α i = 2 m i − m i new , p ij = 2 s ij − m i new , ← α i ℓ i + j ∑ p ij , O i ← α i O i + j ∑ p ij v j . 如果每行事先给定一个固定偏移 a ^ i \hat a_i a ^ i
p i j = 2 s i j − a ^ i , ℓ i ← ℓ i + ∑ j p i j , O i ← O i + ∑ j p i j v j .
p_{ij}=2^{\,s_{ij}-\hat a_i},\qquad \ell_i\leftarrow\ell_i+\sum_jp_{ij},\qquad O_i\leftarrow O_i+\sum_jp_{ij}v_j .
p ij = 2 s ij − a ^ i , ℓ i ← ℓ i + j ∑ p ij , O i ← O i + j ∑ p ij v j . EchoSparse 取 a ^ i \hat a_i a ^ i 固定偏移路径 和 online 回退路径 。
参数取 BM=128、BN=64、D=Dv=128,scale2=log2(e)/sqrt(D)。原始 token 的 log_count 为 0,代表项为 log 2 n \log_2 n log 2 n
# Online softmax
m = tl.full((BM,), -float("inf"), tl.float32)
l = tl.zeros((BM,), tl.float32)
acc = tl.zeros((BM, Dv), tl.float32)
for k, v, log_count in kv_tiles:
    s2 = tl.dot(q, tl.trans(k)) * scale2 + log_count[None, :]
    block_max = tl.max(s2, axis=1)
    m_new = tl.maximum(m, block_max)
    alpha = tl.exp2(m - m_new)
    p = tl.exp2(s2 - m_new[:, None])
    l = l * alpha + tl.sum(p, axis=1)
    acc = acc * alpha[:, None]
    acc = tl.dot(p.to(tl.bfloat16), v, acc)
    m = m_new
out = acc / l[:, None]
new_lse2 = m + tl.log2(l)

# Fixed offset
prior2 = tl.load(PREV_LSE2 + rows * H + head)
l = tl.zeros((BM,), tl.float32)
acc = tl.zeros((BM, Dv), tl.float32)
for k, v, log_count in kv_tiles:
    s2 = tl.dot(q, tl.trans(k)) * scale2 + log_count[None, :]
    p = tl.exp2(s2 - prior2[:, None])
    l += tl.sum(p, axis=1)
    acc = tl.dot(p.to(tl.bfloat16), v, acc)
out = acc / l[:, None]
new_lse2 = prior2 + tl.log2(l)
每个 KV tile 省掉的计算有:
行最大值归约 :对 128 行、每行 64 个元素求最大值。逻辑上约 128 × 63 128\times63 128 × 63 缩放系数 :128 个 α i = 2 m i − m i new \alpha_i=2^{m_i-m_i^{\text{new}}} α i = 2 m i − m i new 128 × 64 = 8192 128\times64=8192 128 × 64 = 8192 p i j p_{ij} p ij exp 2 \exp_2 exp 2 旧累积量的重缩放 :分母 128 个元素,输出累积器 128 × 128 = 16,384 128\times128=16{,}384 128 × 128 = 16 , 384
这里统计的是逻辑运算量,和机器指令数并不一一对应。累积器位于片上,这些运算也不产生显存流量。它们在每个 KV tile 上都会重复:密度为 0.10 时,每个 query tile 平均约有 118 个精确块,仅精确块循环就有约 190 万次累积器乘法。固定偏移新增的开销只有一项:循环开始前每行读一个 FP32 的上一步 LSE,每个 tile 共 512 字节。QK、逐个 score 的 exp 2 \exp_2 exp 2 log 2 ℓ \log_2\ell log 2 ℓ
固定偏移还缩短了依赖链:
online:  S ──> row max ──> m_new ──> exp2(S - m_new) ──> P·V ──┐
                             └──> alpha ──> scale old O ───────┴──> O
fixed:   S ──────────────────────> exp2(S - prior) ──> P·V ──────> O
在 online 版本中,p i j p_{ij} p ij O O O O O O α \alpha α S → exp 2 → P V S\to\exp_2\to PV S → exp 2 → P V
在 B200 上,目前固定偏移的 CuTe DSL 实现把 O O O tO,只在第一次清零。循环中,kernel 从 TMEM 读出 score,减去固定的 LSE,做 exp 2 \exp_2 exp 2 O O O 源码 )。整个过程没有逐轮的 O O O
固定偏移不改变计算结果
对同一组项,分子和分母都乘以同一个 2 − a ^ i 2^{-\hat a_i} 2 − a ^ i
O i ℓ i = ∑ j 2 s i j − a ^ i v j ∑ j 2 s i j − a ^ i = ∑ j 2 s i j v j ∑ j 2 s i j , a ^ i + log 2 ℓ i = log 2 ∑ j 2 s i j .
\frac{O_i}{\ell_i}=\frac{\sum_j 2^{s_{ij}-\hat a_i}v_j}{\sum_j 2^{s_{ij}-\hat a_i}}=\frac{\sum_j 2^{s_{ij}}v_j}{\sum_j 2^{s_{ij}}},\qquad
\hat a_i+\log_2\ell_i=\log_2\sum_j2^{s_{ij}} .
ℓ i O i = ∑ j 2 s ij − a ^ i ∑ j 2 s ij − a ^ i v j = ∑ j 2 s ij ∑ j 2 s ij v j , a ^ i + log 2 ℓ i = log 2 j ∑ 2 s ij . 最后的除数是本步累加出的 ℓ i \ell_i ℓ i a ^ i \hat a_i a ^ i l s e i ( 2 ) \mathrm{lse}^{(2)}_i lse i ( 2 ) ℓ i = 2 l s e i ( 2 ) − a ^ i \ell_i=2^{\,\mathrm{lse}^{(2)}_i-\hat a_i} ℓ i = 2 lse i ( 2 ) − a ^ i ℓ i \ell_i ℓ i p i j p_{ij} p ij
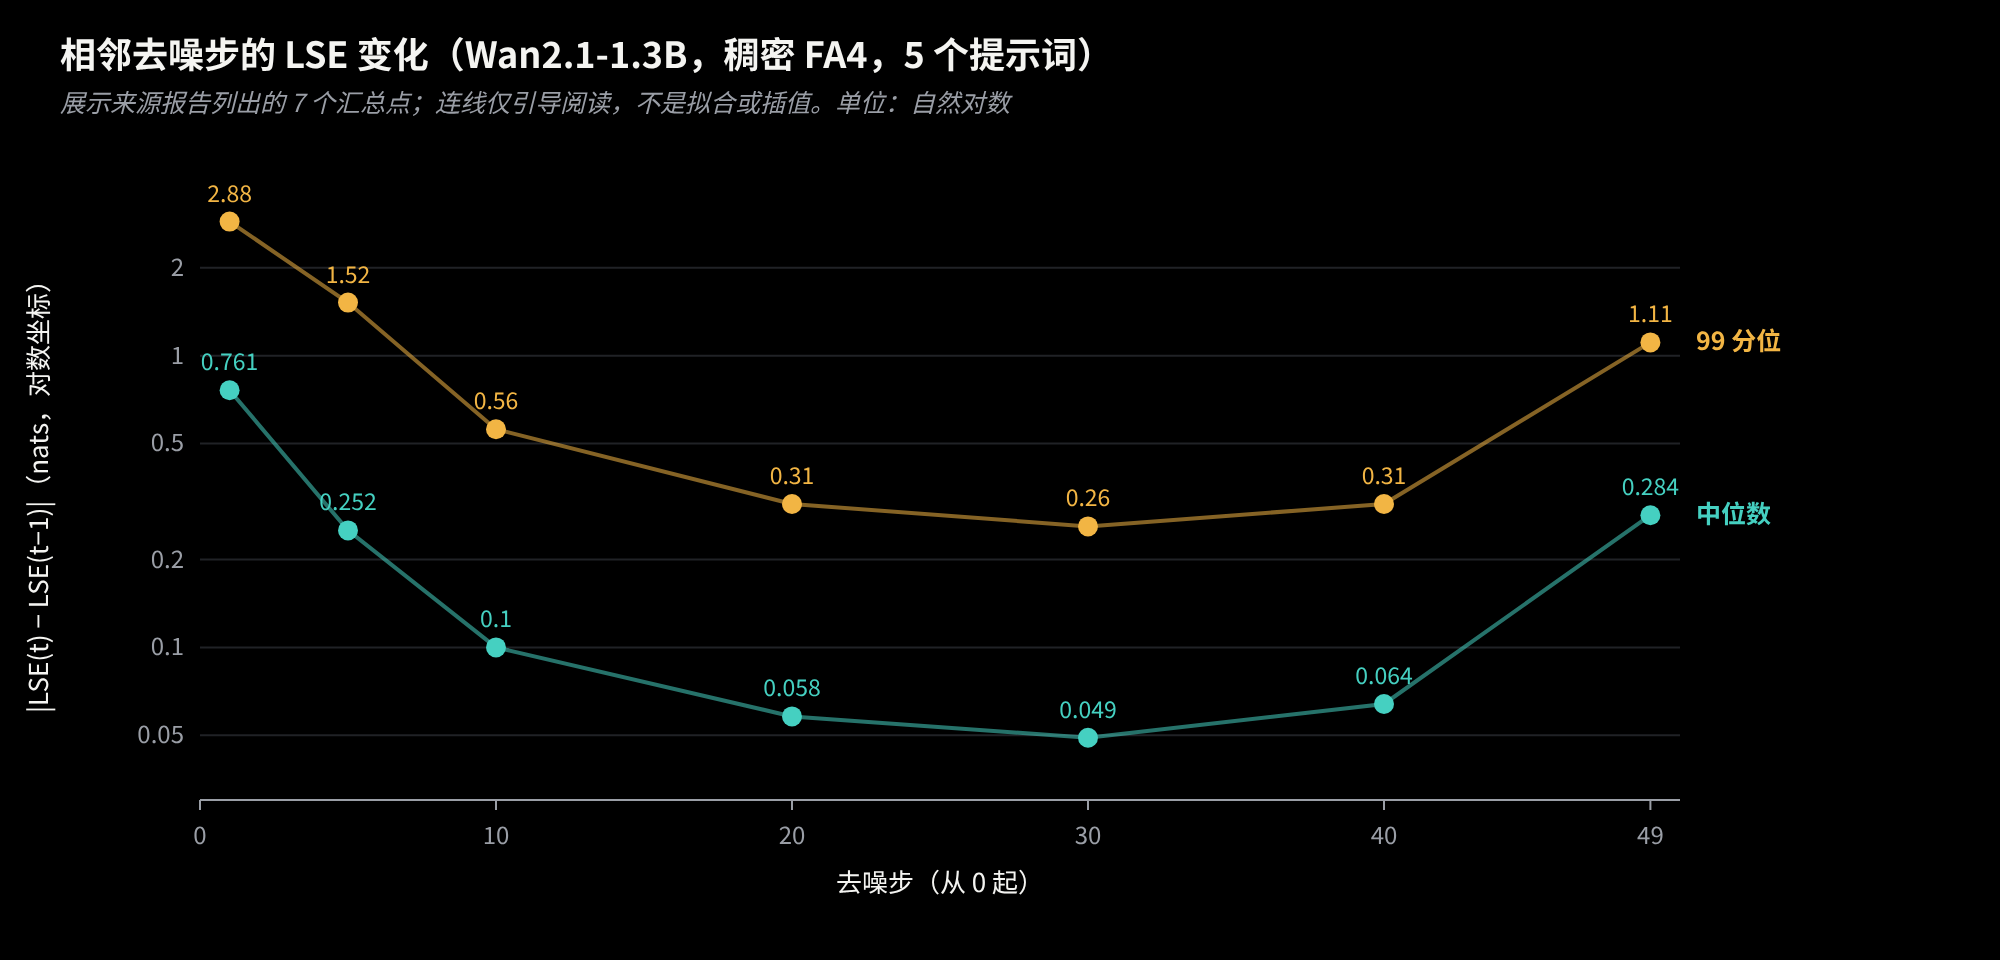
图 1 相邻去噪步之间同一行 LSE 的变化(Wan2.1-1.3B,稠密 FA4,5 个提示词,自然对数单位,B200 上的早期实验)。图中的点是报告给出的 7 个汇总值。数据:REPORT.md §3 。 去噪中段,变化的中位数只有 0.05 到 0.1。第 1 步的中位数是 0.76,第 49 步是 0.28,对应的 p99 分别是 2.88 和 1.11。个别(层,头)组合上的变化达到 100 以上。因此 kernel 在循环结束后检查 log 2 ℓ i \log_2\ell_i log 2 ℓ i ± 60 \pm60 ± 60
3. 多层级代表块
3.1 多层级表示
把块 b b b m b m_b m b ( k ~ a , v ~ a , n a ) (\tilde k_a,\tilde v_a,n_a) ( k ~ a , v ~ a , n a )
o ~ = ∑ a n a e q ⊤ k ~ a / d v ~ a ∑ a n a e q ⊤ k ~ a / d .
\tilde o=\frac{\sum_a n_a\,e^{\,q^\top\tilde k_a/\sqrt d}\,\tilde v_a}{\sum_a n_a\,e^{\,q^\top\tilde k_a/\sqrt d}} .
o ~ = ∑ a n a e q ⊤ k ~ a / d ∑ a n a e q ⊤ k ~ a / d v ~ a .
m b = 1 m_b=1 m b = 1 n = n b n=n_b n = n b m b = 4 m_b=4 m b = 4 m b = 64 m_b=64 m b = 64 n = 1 n=1 n = 1
2、8、16、32 也是可选的档位,目前代码只实现了 1、4、64。构造四代表的 kernel 把聚类数补到 16 行,以满足 tl.dot 的最小尺寸要求。
n a n_a n a ln n a = − ∞ \ln n_a=-\infty ln n a = − ∞
m b m_b m b s = ( 0 , 0 , 2 , 2 ) s=(0,0,2,2) s = ( 0 , 0 , 2 , 2 ) v = ( 1 , 1 , 0 , 0 ) v=(1,1,0,0) v = ( 1 , 1 , 0 , 0 ) 2 / ( 2 + 2 e 2 ) ≈ 0.119 2/(2+2e^2)\approx0.119 2/ ( 2 + 2 e 2 ) ≈ 0.119 n = 4 n=4 n = 4 v v v ( 0 , 0 ) (0,0) ( 0 , 0 ) ( 2 , 2 ) (2,2) ( 2 , 2 ) n = 2 n=2 n = 2
每块读取 m b ( d + d v ) m_b(d+d_v) m b ( d + d v ) 2 B q m b ( d + d v ) 2B_qm_b(d+d_v) 2 B q m b ( d + d v )
3.2 按块质量选择 m b = 1 m_b=1 m b = 1 4 4 4 64 64 64
对 query tile a a a b b b
M a b = ∑ i ∈ a ∑ j ∈ b e s i j − c i , c i = ( ln 2 ) a ^ i ,
M_{ab}=\sum_{i\in a}\sum_{j\in b}e^{\,s_{ij}-c_i},\qquad c_i=(\ln2)\,\hat a_i ,
M ab = i ∈ a ∑ j ∈ b ∑ e s ij − c i , c i = ( ln 2 ) a ^ i , 这里使用自然对数单位:s i j = q i ⊤ k j / d s_{ij}=q_i^\top k_j/\sqrt d s ij = q i ⊤ k j / d c i c_i c i a ^ i \hat a_i a ^ i p i j = 2 s i j ( 2 ) − a ^ i p_{ij}=2^{\,s^{(2)}_{ij}-\hat a_i} p ij = 2 s ij ( 2 ) − a ^ i s i j ( 2 ) = s i j log 2 e s^{(2)}_{ij}=s_{ij}\log_2 e s ij ( 2 ) = s ij log 2 e e s i j − c i e^{s_{ij}-c_i} e s ij − c i M a b M_{ab} M ab M a b M_{ab} M ab a a a b b b
这张质量图由本步的 attention kernel 在计算过程中顺带得到,没有单独的打分步骤:
精确块 :e s i j − c i e^{s_{ij}-c_i} e s ij − c i p i j p_{ij} p ij M a b M_{ab} M ab 落选块 :没有精确的 s i j s_{ij} s ij estimate_skipped 在每个 query tile 中抽取若干行,用块均值估计落选块的质量,再用同一 tile 中已精确计算的块校准。校准系数限制在 [ 1 , 64 ] [1,64] [ 1 , 64 ]
两部分按 tile 汇总后,再乘以 exp ( c i − L S E i new ) \exp(c_i-\mathrm{LSE}^{\text{new}}_i) exp ( c i − LSE i new ) L S E i new \mathrm{LSE}^{\text{new}}_i LSE i new 2^(prior2 - new_lse2)。
下一步按质量排序分配:共有 n blk n_{\text{blk}} n blk ρ \rho ρ r o u n d ( ρ n blk ) \mathrm{round}(\rho\,n_{\text{blk}}) round ( ρ n blk )
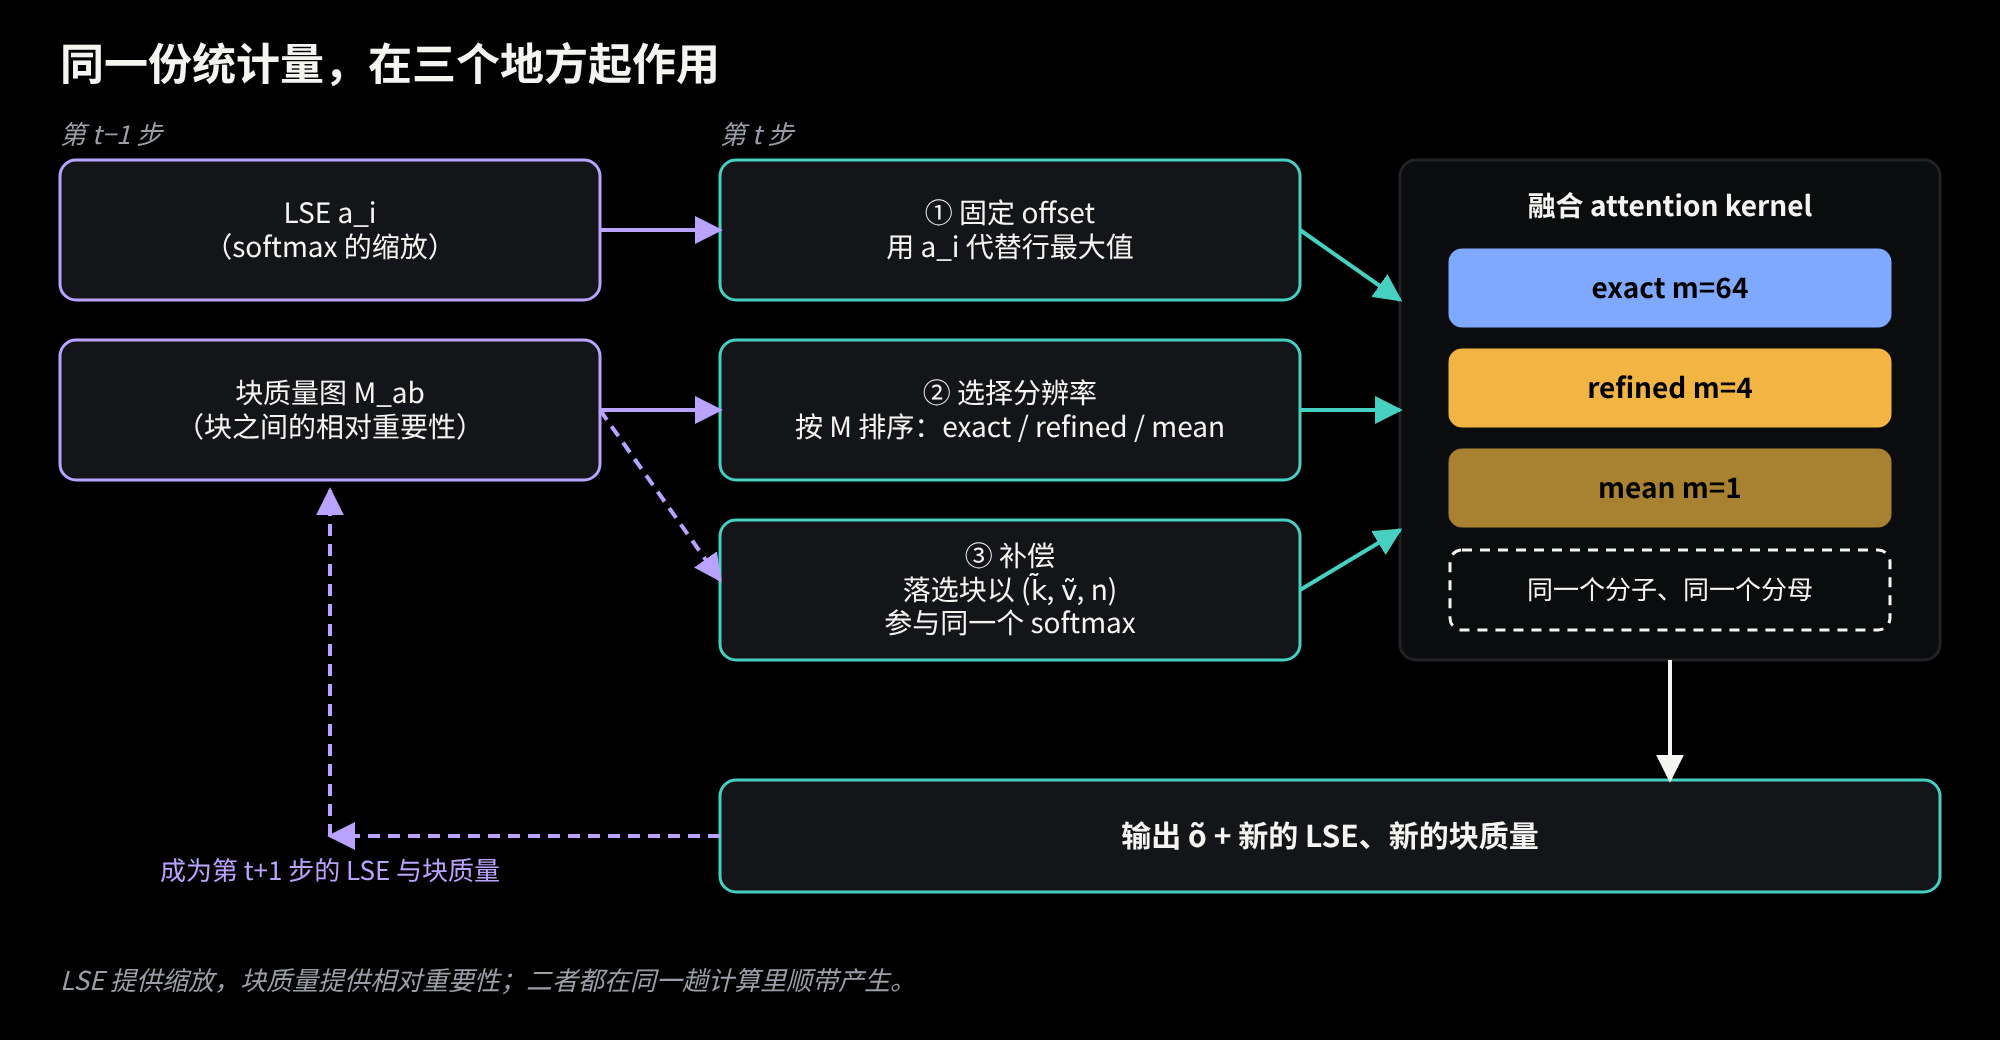
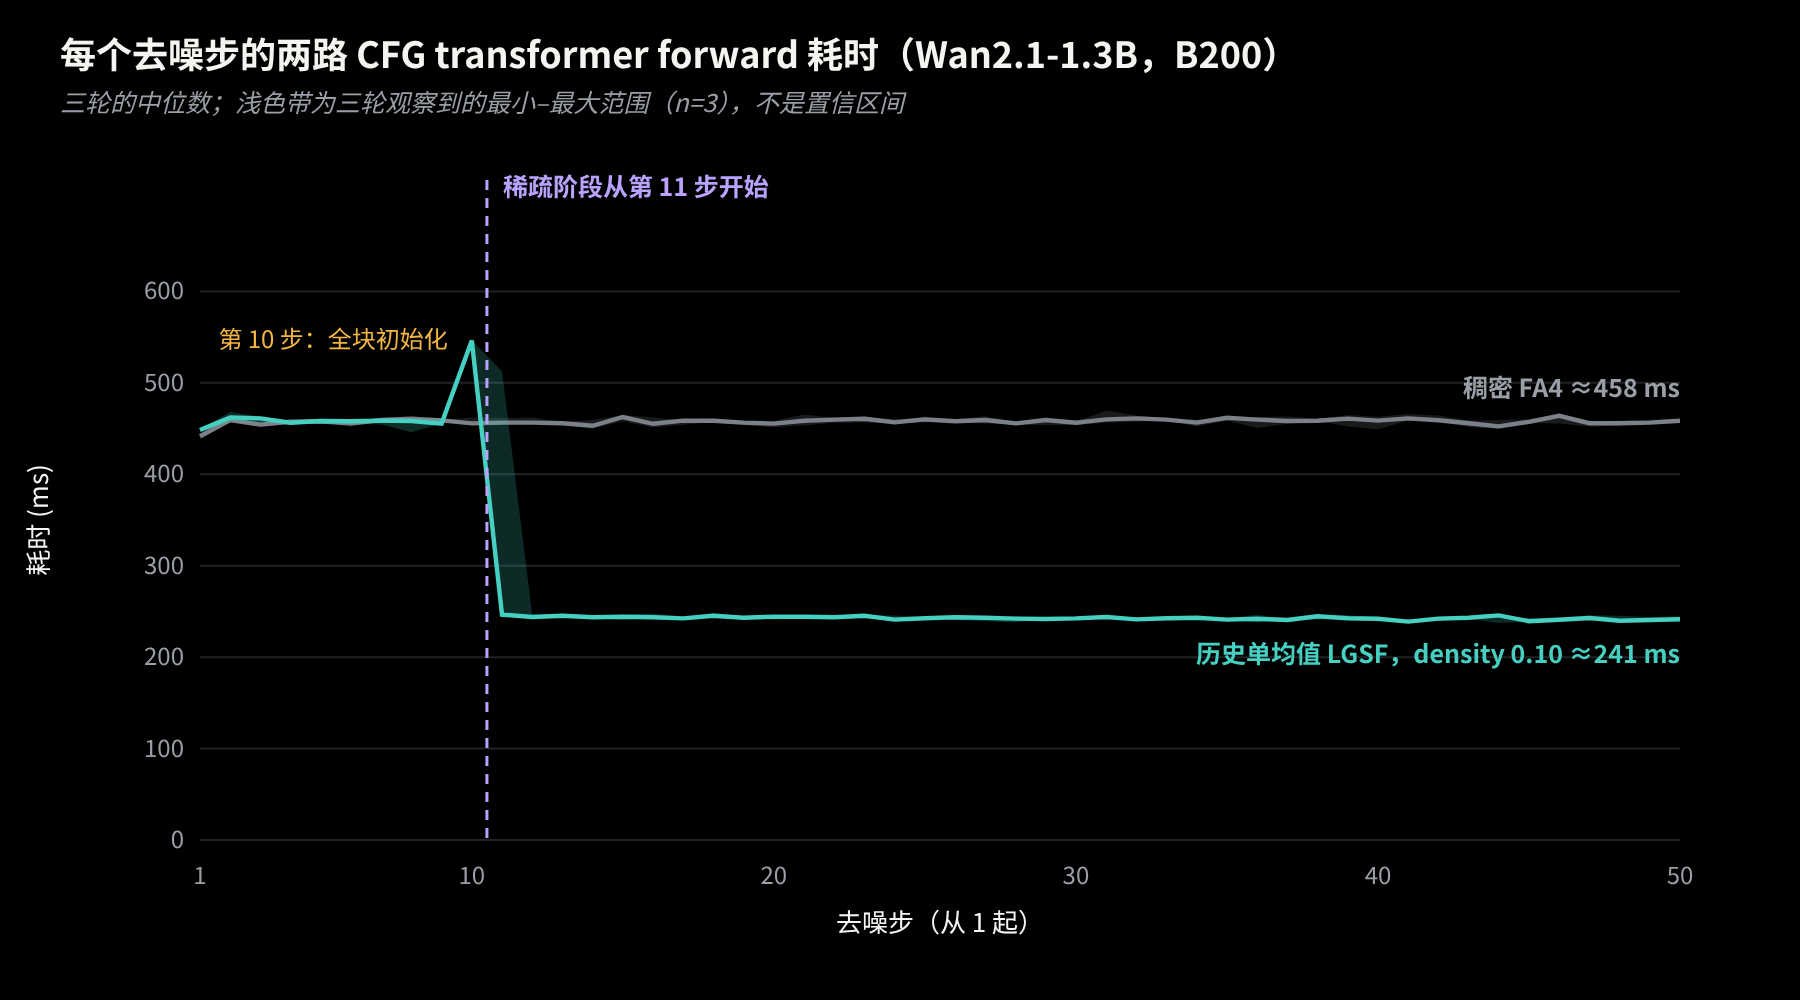
图 2 LSE 作为固定偏移,块质量决定每个块用多少代表;kernel 输出下一步使用的 LSE 和块质量。 每个(CFG 分支,层)各自保存状态,CFG 的其他分支可以复用分支 0 的块选择。默认设置下,前 9 步用 FA4 做稠密计算。第 10 步让所有块都经过固定偏移的 EchoSparse kernel,输出是精确的,同时建立第一张质量图。第 11 步起进入稀疏计算。
图 3 B200 早期实验:Wan2.1-1.3B 每个去噪步两路 CFG forward 的耗时(三次运行的中位数和范围)。稀疏组使用早期的单均值版本,未包含当前的四代表和打包实现。数据:curve13.json 。 3.3 近似误差与聚类目标
考虑一组 C C C n n n k ˉ , v ˉ \bar k,\bar v k ˉ , v ˉ s ˉ = q ⊤ k ˉ / d \bar s=q^\top\bar k/\sqrt d s ˉ = q ⊤ k ˉ / d δ j = q ⊤ ( k j − k ˉ ) / d \delta_j=q^\top(k_j-\bar k)/\sqrt d δ j = q ⊤ ( k j − k ˉ ) / d E C δ = 0 \mathbb E_C\delta=0 E C δ = 0
Z C = n e s ˉ E C e δ , Z ^ C = n e s ˉ , E C e δ = 1 + 1 2 E C δ 2 + O ( E C ∣ δ ∣ 3 ) .
Z_C=n\,e^{\bar s}\,\mathbb E_Ce^{\delta},\qquad \widehat Z_C=n\,e^{\bar s},\qquad
\mathbb E_Ce^{\delta}=1+\tfrac12\mathbb E_C\delta^2+O\bigl(\mathbb E_C|\delta|^3\bigr).
Z C = n e s ˉ E C e δ , Z C = n e s ˉ , E C e δ = 1 + 2 1 E C δ 2 + O ( E C ∣ δ ∣ 3 ) . 由于使用普通均值,一阶项相互抵消,分母误差的主项是组内 logit 方差。若 ∣ δ j ∣ ≤ r |\delta_j|\le r ∣ δ j ∣ ≤ r e δ − 1 − δ = 1 2 δ 2 e ξ e^\delta-1-\delta=\tfrac12\delta^2e^{\xi} e δ − 1 − δ = 2 1 δ 2 e ξ
0 ≤ Z C − Z ^ C ≤ n e s ˉ + r 2 E C δ 2 .
0\le Z_C-\widehat Z_C\le\frac{n\,e^{\bar s+r}}{2}\,\mathbb E_C\delta^2 .
0 ≤ Z C − Z C ≤ 2 n e s ˉ + r E C δ 2 . 左边非负来自 Jensen 不等式:代表总是低估这一组的分母。分子误差还和 value 有关:
N C − N ^ C = n e s ˉ [ C o v C ( δ , v ) + 1 2 E C ( δ 2 v ) + ⋯ ] .
\mathcal N_C-\widehat{\mathcal N}_C=n\,e^{\bar s}\Bigl[\mathrm{Cov}_C(\delta,v)+\tfrac12\,\mathbb E_C\bigl(\delta^2v\bigr)+\cdots\Bigr].
N C − N C = n e s ˉ [ Cov C ( δ , v ) + 2 1 E C ( δ 2 v ) + ⋯ ] . 第一项就是组内一阶矩 H C ⊤ q / ( n d ) H_C^\top q/(n\sqrt d) H C ⊤ q / ( n d )
H b = ∑ C H C + ∑ C n C ( k ˉ C − k ˉ b ) ( v ˉ C − v ˉ b ) ⊤ .
H_b=\sum_C H_C+\sum_C n_C\,(\bar k_C-\bar k_b)(\bar v_C-\bar v_b)^\top .
H b = C ∑ H C + C ∑ n C ( k ˉ C − k ˉ b ) ( v ˉ C − v ˉ b ) ⊤ . 分成 m b m_b m b m b ( d + d v ) m_b(d+d_v) m b ( d + d v ) d × d v d\times d_v d × d v H C H_C H C d d v dd_v d d v
分母误差的主项由组内 logit 方差决定,所以可以把平均平方 logit 偏差作为分组的目标。把当前 head 的所有 query 按行排成 Q ∈ R N × d Q\in\mathbb R^{N\times d} Q ∈ R N × d B k B_k B k b b b C b \mathcal C_b C b Δ k j = k j − k ˉ C \Delta k_j=k_j-\bar k_C Δ k j = k j − k ˉ C
J b = 1 N B k ∑ i = 1 N ∑ C ∈ C b ∑ j ∈ C ( q i ⊤ Δ k j d ) 2 .
J_b=\frac1{NB_k}\sum_{i=1}^N\sum_{C\in\mathcal C_b}\sum_{j\in C}
\left(\frac{q_i^\top\Delta k_j}{\sqrt d}\right)^2 .
J b = N B k 1 i = 1 ∑ N C ∈ C b ∑ j ∈ C ∑ ( d q i ⊤ Δ k j ) 2 . 直接按这个式子计算时,每次调整分组都要遍历所有 query。但 q i q_i q i
G = 1 N d ∑ i = 1 N q i q i ⊤ = Q ⊤ Q N d , J b = 1 B k ∑ C ∈ C b ∑ j ∈ C Δ k j ⊤ G Δ k j .
\begin{aligned}
G&=\frac1{Nd}\sum_{i=1}^N q_iq_i^\top=\frac{Q^\top Q}{Nd},\\
J_b&=\frac1{B_k}\sum_{C\in\mathcal C_b}\sum_{j\in C}\Delta k_j^\top G\,\Delta k_j .
\end{aligned}
G J b = N d 1 i = 1 ∑ N q i q i ⊤ = N d Q ⊤ Q , = B k 1 C ∈ C b ∑ j ∈ C ∑ Δ k j ⊤ G Δ k j . 这样,所有 query 的作用都汇总到一个 d × d d\times d d × d G G G Q ⊤ Q Q^\top Q Q ⊤ Q N × d N\times d N × d d × d d\times d d × d d = 128 d=128 d = 128 128 × 128 128\times128 128 × 128 O ( N d 2 ) O(Nd^2) O ( N d 2 ) Q K ⊤ QK^\top Q K ⊤ O ( N 2 d ) O(N^2d) O ( N 2 d ) G G G
接下来要高效计算 Δ k ⊤ G Δ k \Delta k^\top G\Delta k Δ k ⊤ G Δ k O ( d 2 ) O(d^2) O ( d 2 ) G G G
G ϵ = G + ϵ I = M M ⊤ , ϵ = 10 − 3 tr ( G ) d .
G_\epsilon=G+\epsilon I=MM^\top,\qquad
\epsilon=10^{-3}\frac{\operatorname{tr}(G)}d .
G ϵ = G + ϵ I = M M ⊤ , ϵ = 1 0 − 3 d tr ( G ) . 二次型于是变成普通的平方长度:
Δ k ⊤ G ϵ Δ k = Δ k ⊤ M M ⊤ Δ k = ∥ M ⊤ Δ k ∥ 2 , = Δ k ⊤ G Δ k + ϵ ∥ Δ k ∥ 2 .
\begin{aligned}
\Delta k^\top G_\epsilon\Delta k
&=\Delta k^\top MM^\top\Delta k=\|M^\top\Delta k\|^2,\\
&=\Delta k^\top G\Delta k+\epsilon\|\Delta k\|^2 .
\end{aligned}
Δ k ⊤ G ϵ Δ k = Δ k ⊤ M M ⊤ Δ k = ∥ M ⊤ Δ k ∥ 2 , = Δ k ⊤ G Δ k + ϵ ∥Δ k ∥ 2 . 所以只要预先把 key 变换为 x j = M ⊤ k j x_j=M^\top k_j x j = M ⊤ k j X = K M X=KM X = K M x ˉ C = M ⊤ k ˉ C \bar x_C=M^\top\bar k_C x ˉ C = M ⊤ k ˉ C
J b , ϵ = J b + ϵ B k ∑ C ∈ C b ∑ j ∈ C ∥ Δ k j ∥ 2 , = 1 B k ∑ C ∈ C b ∑ j ∈ C ∥ x j − x ˉ C ∥ 2 .
\begin{aligned}
J_{b,\epsilon}
&=J_b+\frac\epsilon{B_k}\sum_{C\in\mathcal C_b}\sum_{j\in C}\|\Delta k_j\|^2,\\
&=\frac1{B_k}\sum_{C\in\mathcal C_b}\sum_{j\in C}\|x_j-\bar x_C\|^2 .
\end{aligned}
J b , ϵ = J b + B k ϵ C ∈ C b ∑ j ∈ C ∑ ∥Δ k j ∥ 2 , = B k 1 C ∈ C b ∑ j ∈ C ∑ ∥ x j − x ˉ C ∥ 2 . 这正是变换后坐标中的 k-means 平方距离目标。Cholesky 分解的计算量为 O ( d 3 ) O(d^3) O ( d 3 ) d × d d\times d d × d M M M K M KM K M O ( B k m b d ) O(B_km_bd) O ( B k m b d ) N N N
实现中还用 64 个探测 query(probe query)给 token 加权,使经常获得较高 attention 权重的 token 在分组中占更大比重。初始分组是四个连续的 16-token 组,之后最多做 6 次加权 Lloyd 迭代,中心按权重更新。分组确定后,写回的 K、V 仍是组内的普通均值,n a n_a n a
4. 打包:把 1+1+4 拼成 6 列
实验形状 N = 75600 N=75600 N = 75600 n blk = 1182 n_{\text{blk}}=1182 n blk = 1182 118 × 64 ≈ 7.6 118\times64\approx7.6 118 × 64 ≈ 7.6 1420 + 709 = 2129 1420+709=2129 1420 + 709 = 2129
逐块计算时,这些是一串 ( B q × d ) ( d × 1 ) (B_q\times d)(d\times1) ( B q × d ) ( d × 1 ) ( B q × d ) ( d × 4 ) (B_q\times d)(d\times4) ( B q × d ) ( d × 4 ) ( B q × d ) ( d × [ 1 + 1 + 4 ] ) (B_q\times d)(d\times[1+1+4]) ( B q × d ) ( d × [ 1 + 1 + 4 ])
K ∗ = [ k ˉ 1 ⊤ k ˉ 2 ⊤ K 3 ( 4 ) ] ∈ R 6 × d , V ∗ = [ v ˉ 1 ⊤ v ˉ 2 ⊤ V 3 ( 4 ) ] ∈ R 6 × d v , n ∗ = ( n 1 , n 2 , n 3 , 1 , … , n 3 , 4 ) .
K_*=\begin{bmatrix}\bar k_1^\top\\ \bar k_2^\top\\ K_3^{(4)}\end{bmatrix}\in\mathbb R^{6\times d},\qquad
V_*=\begin{bmatrix}\bar v_1^\top\\ \bar v_2^\top\\ V_3^{(4)}\end{bmatrix}\in\mathbb R^{6\times d_v},\qquad
n_*=(n_1,\,n_2,\,n_{3,1},\,\dots,\,n_{3,4}) .
K ∗ = k ˉ 1 ⊤ k ˉ 2 ⊤ K 3 ( 4 ) ∈ R 6 × d , V ∗ = v ˉ 1 ⊤ v ˉ 2 ⊤ V 3 ( 4 ) ∈ R 6 × d v , n ∗ = ( n 1 , n 2 , n 3 , 1 , … , n 3 , 4 ) . 然后
S = Q K ∗ ⊤ d ∈ R B q × 6 , W = exp ( S − c 1 ⊤ + 1 ( ln n ∗ ) ⊤ ) ,
S=\frac{QK_*^\top}{\sqrt d}\in\mathbb R^{B_q\times6},\qquad
W=\exp\bigl(S-c\,\mathbf 1^\top+\mathbf 1\,(\ln n_*)^\top\bigr),
S = d Q K ∗ ⊤ ∈ R B q × 6 , W = exp ( S − c 1 ⊤ + 1 ( ln n ∗ ) ⊤ ) , N + = W V ∗ , D + = W 1 , O = d i a g ( D ) − 1 N .
\mathcal N\mathrel{+}=WV_*,\qquad \mathcal D\mathrel{+}=W\mathbf 1,\qquad O=\mathrm{diag}(\mathcal D)^{-1}\mathcal N .
N + = W V ∗ , D + = W 1 , O = diag ( D ) − 1 N . c c c c i = ( ln 2 ) a ^ i c_i=(\ln2)\,\hat a_i c i = ( ln 2 ) a ^ i Q K ∗ ⊤ QK_*^\top Q K ∗ ⊤ W W W [ W 1 W 2 W 3 ] [W_1\ W_2\ W_3] [ W 1 W 2 W 3 ]
W V ∗ = W 1 v ˉ 1 ⊤ + W 2 v ˉ 2 ⊤ + W 3 V 3 ( 4 ) , W 1 = W 1 1 + W 2 1 + W 3 1 ,
WV_*=W_1\bar v_1^\top+W_2\bar v_2^\top+W_3V_3^{(4)},\qquad W\mathbf 1=W_1\mathbf 1+W_2\mathbf 1+W_3\mathbf 1 ,
W V ∗ = W 1 v ˉ 1 ⊤ + W 2 v ˉ 2 ⊤ + W 3 V 3 ( 4 ) , W 1 = W 1 1 + W 2 1 + W 3 1 , 即三个块对分子和分母的贡献都加进了同一个 N \mathcal N N D \mathcal D D n ∗ n_* n ∗ N \mathcal N N D \mathcal D D
因此,在相同的稀疏计划、代表 K/V、token 数和统一归一化下,打包只改变计算的分组方式,数学上输出相同。EchoSparse 相对稠密计算的全部近似都来自上一节的代表压缩。浮点求和顺序的改变会带来细微的舍入差别。
6 列远不够填满一个 Tensor Core tile,实际需要跨很多块拼接。实验分支每次迭代处理 128 列:均值流一次拼接 128 个块的均值,四代表流一次拼接 32 个块、每块 4 列。每条流只有最后一次迭代需要掩码。
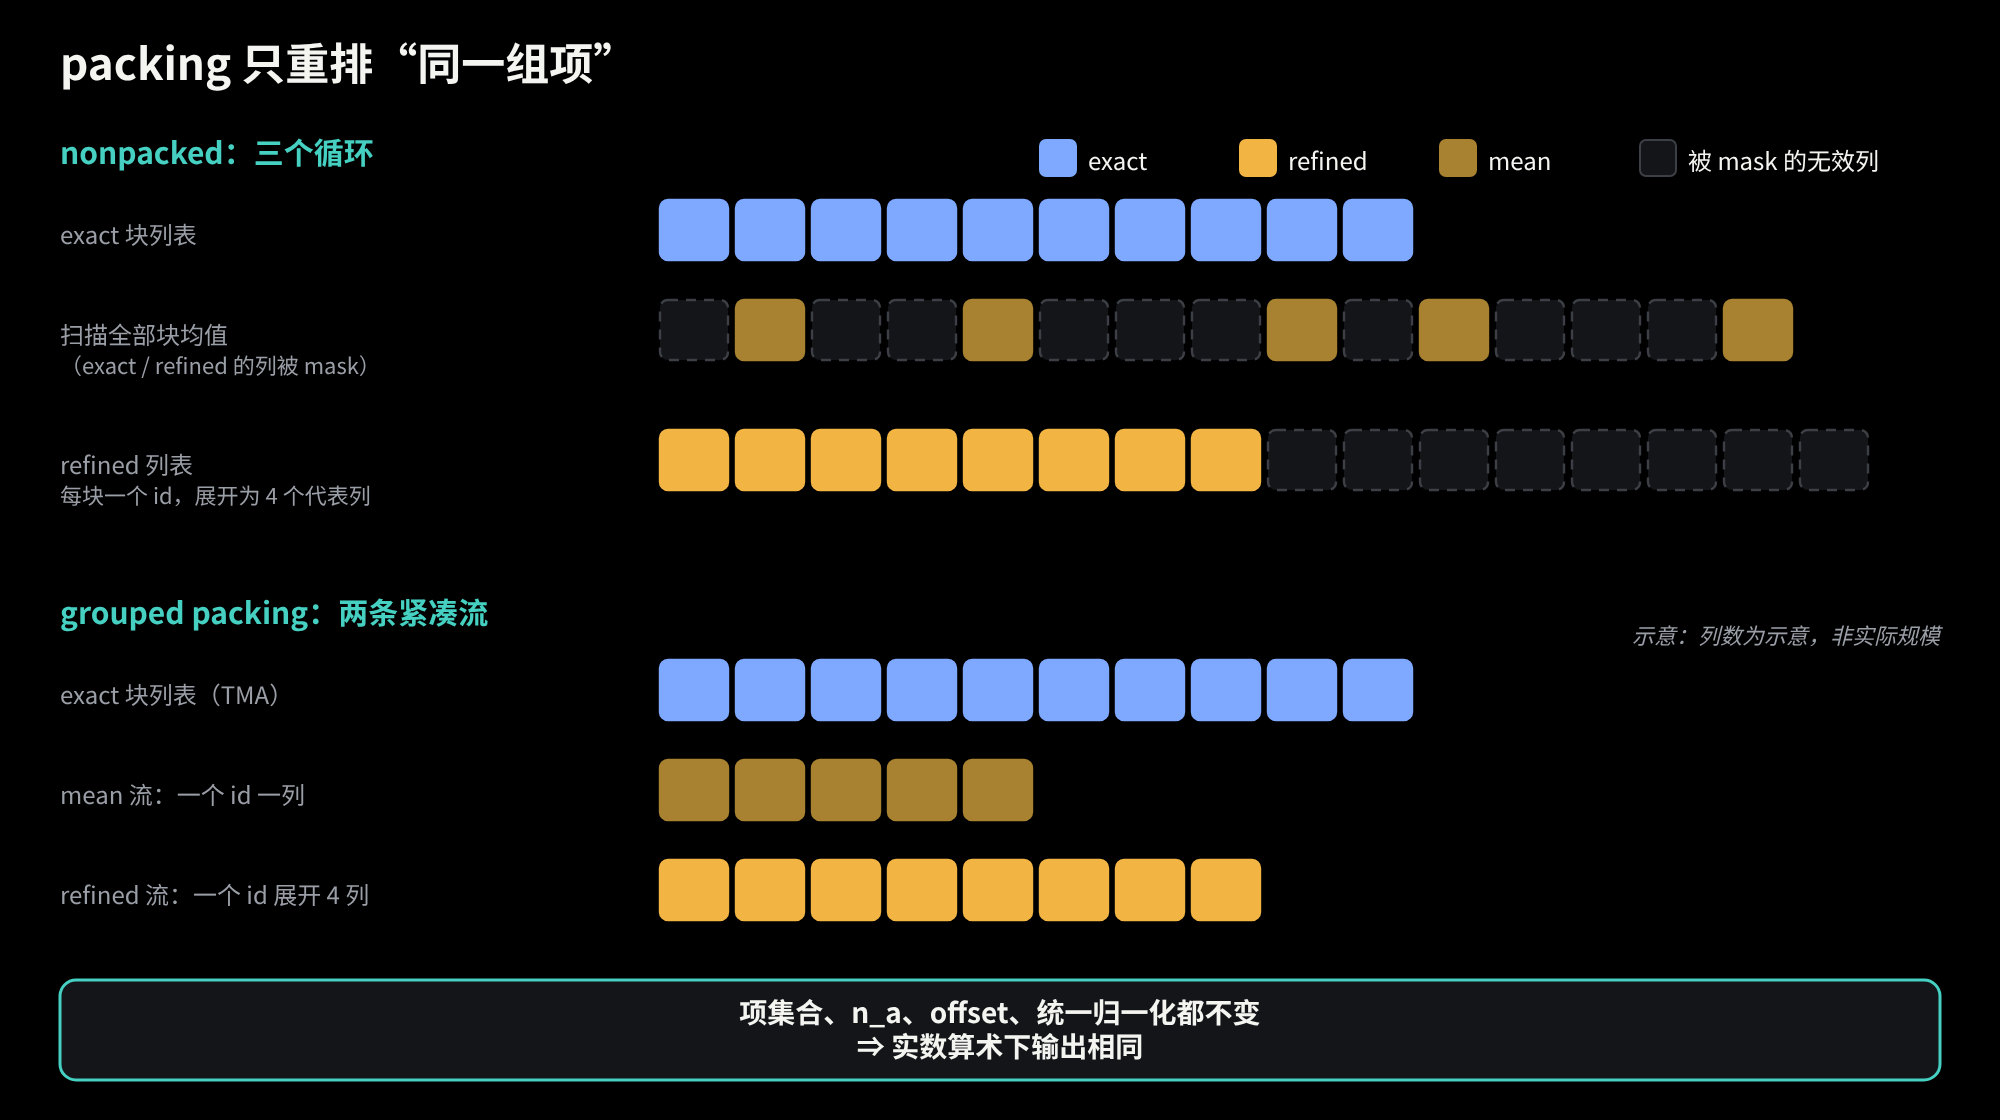
已发布版本没有做打包(图中标为 nonpacked),它有三个循环:第一个遍历精确块列表;第二个以 128 列为单位扫描全部块的均值,并用掩码屏蔽精确块和四代表块对应的列;第三个遍历四代表块列表,每块一个 id,展开成 4 列,列表补齐到固定宽度。在这次测试的计划中,每个 tile 要处理 1280 个均值列和 1536 个代表列,共 2816 列,平均只有 2129 列有用,约占 76%。被屏蔽的列可以不搬数据,但 MMA 按固定形状发射,这部分计算开销仍然存在。
图 4 示意图:同一组项在未打包的三个循环(nonpacked)和分组打包的两条流(grouped)中的排布,列数不按比例。 实验分支的分组打包(grouped packing)为每个(query tile,head)生成两条紧凑的索引流,代码中称为 descriptor。均值流中一个块 id 对应一列;四代表流中一个块 id 对应 4 列,在片上按 4 ⋅ block + sub 4\cdot\text{block}+\text{sub} 4 ⋅ block + sub
打包只作用于索引。代表 K/V 没有复制成连续张量,每次迭代仍按索引从原位置读取(gather)。
5. 数据搬运与流水线
如果把每个 tile 用到的代表 K/V 复制成连续张量,就可以像精确块一样整块搬运。但复制本身要读一次、写一次,kernel 还要再读一次,而且每个(query tile,head)选中的块都不同。按每个 tile 平均 2129 列、每列 d + d v = 256 d+d_v=256 d + d v = 256
不复制时,小块搬运也有固定开销:descriptor 和地址计算、对齐、通知数据到达的 barrier,以及 shared memory 缓冲区。负载越零碎,这些开销越难分摊。因此需要先把有效列拼成足够宽的 tile,再让搬运和计算重叠。
设每次迭代的装载耗时为 t ℓ t_\ell t ℓ t c t_c t c n n n n ( t ℓ + t c ) n(t_\ell+t_c) n ( t ℓ + t c )
t ℓ + ( n − 1 ) max ( t ℓ , t c ) + t c + t sync ,
t_\ell+(n-1)\,\max(t_\ell,t_c)+t_c+t_{\text{sync}},
t ℓ + ( n − 1 ) max ( t ℓ , t c ) + t c + t sync , 首尾两项分别是流水线的填充和排空。不计 t sync t_{\text{sync}} t sync n = 1 n=1 n = 1 t ℓ + t c t_\ell+t_c t ℓ + t c t sync t_{\text{sync}} t sync n n n 7552 / ( 7552 + 2816 ) 7552/(7552+2816) 7552/ ( 7552 + 2816 )
H100 的 TMA(Tensor Memory Accelerator)用一个 descriptor 描述张量的形状,由专用硬件把整块数据异步搬进 shared memory。K、V 的布局是 [N,H,D]。一个 64-token 块是一个按原张量步长描述的矩形 tile(H > 1 H>1 H > 1 [64,1,D] 的 descriptor 在行偏移 64 ⋅ block 64\cdot\text{block} 64 ⋅ block
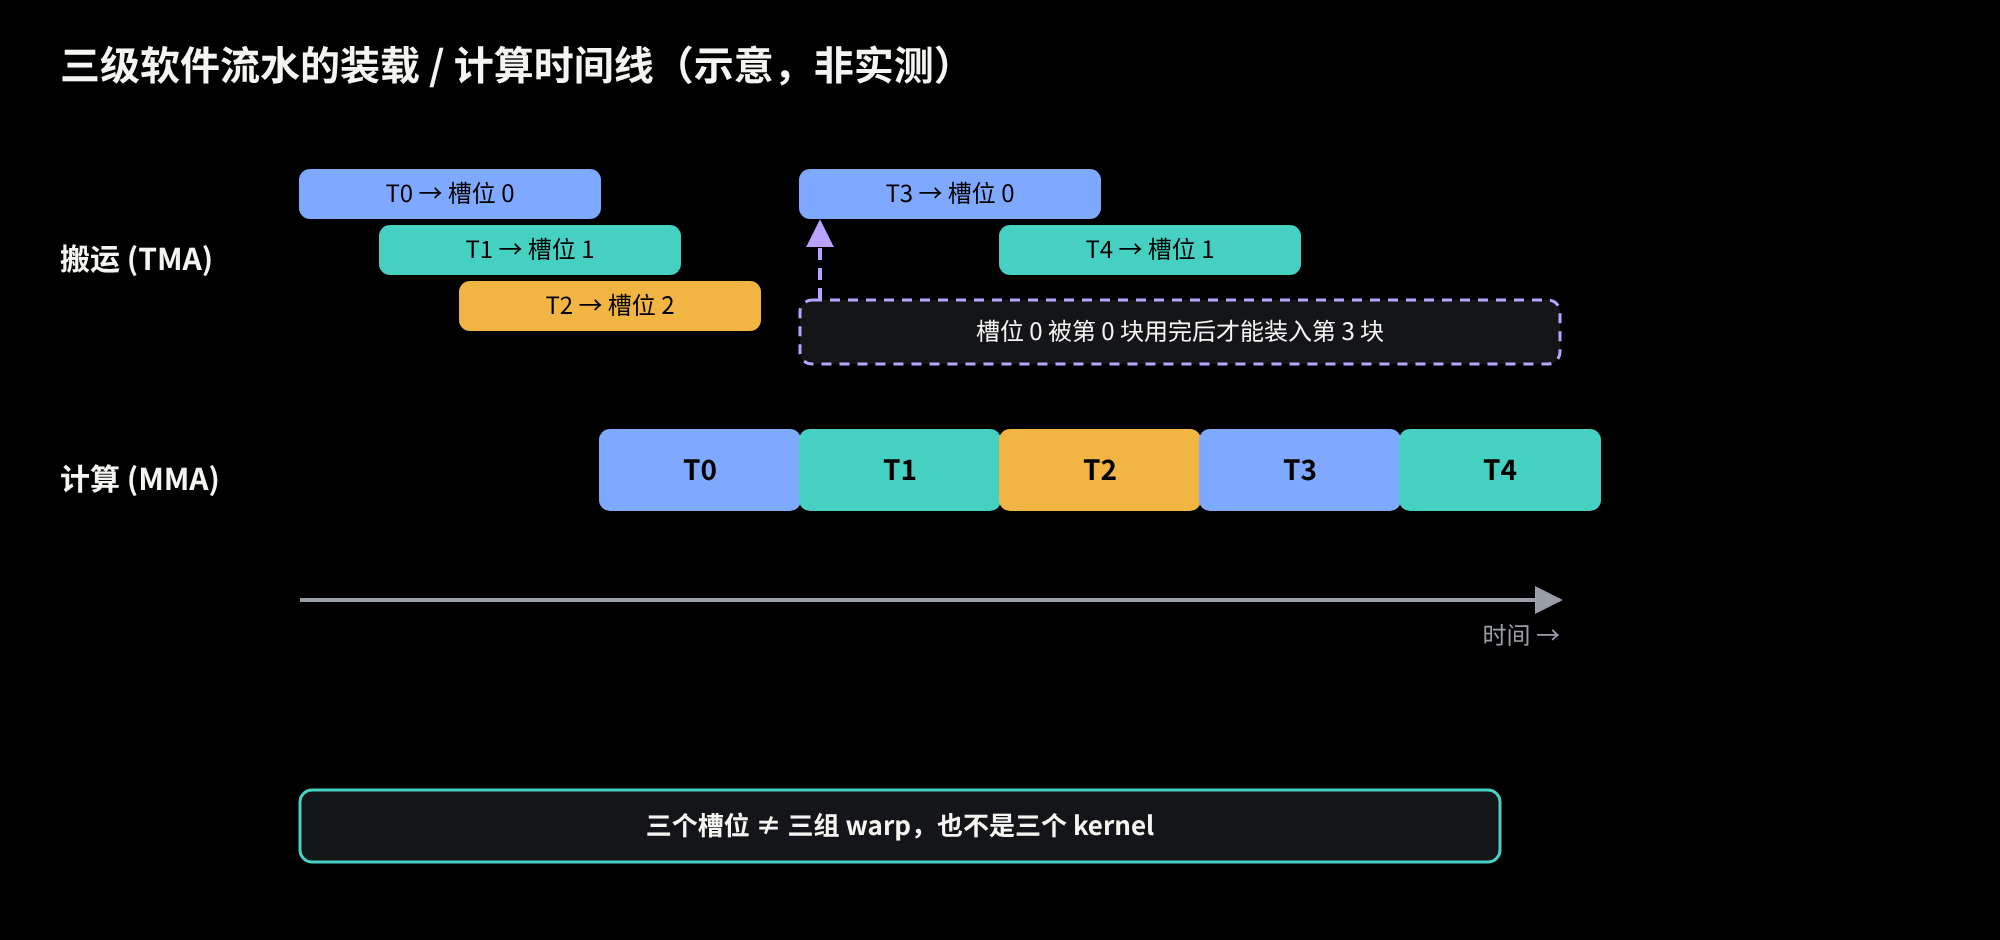
图 5 精确块循环三级软件流水线的示意时间线(非实测)。TMA 只用于精确块。 实验分支目前的做法是:精确块通过 TMA 加载,用三级软件流水线让搬运和 dot 重叠;代表列按分组打包的索引逐列读取。三级流水线由 Triton 的软件流水调度生成,三个 stage 是环形缓冲区的三个槽位。第 0 块计算完、槽位释放后,第 3 块才能装入同一个槽位;计算等待数据到达,装载等待槽位空出。只开 TMA、不加流水线时几乎没有收益(主 kernel 57.15 ms 对 57.22 ms),两者一起使用才有效。流水级数从 3 增加到 6,时间基本不变。
在同一 Wan2.1-14B 计划的 NCU 测量中,加入 TMA 后,指令数从 10.42 G 降到 9.79 G,主 kernel 耗时从 39.06 ms 降到 35.64 ms。barrier 和 wait 仍占约四成 warp 周期。搬运指令减少以后,同步仍是主要开销。
代表流可以改成生产者–消费者(producer–consumer)结构:生产者 warp 按分组打包的索引读取后续的代表列,在 shared memory 的三个槽位里整理成满宽的 tile;消费者 warp 对已就绪的槽位做 QK、exp 2 \exp_2 exp 2 N \mathcal N N D \mathcal D D
6. 实验结果
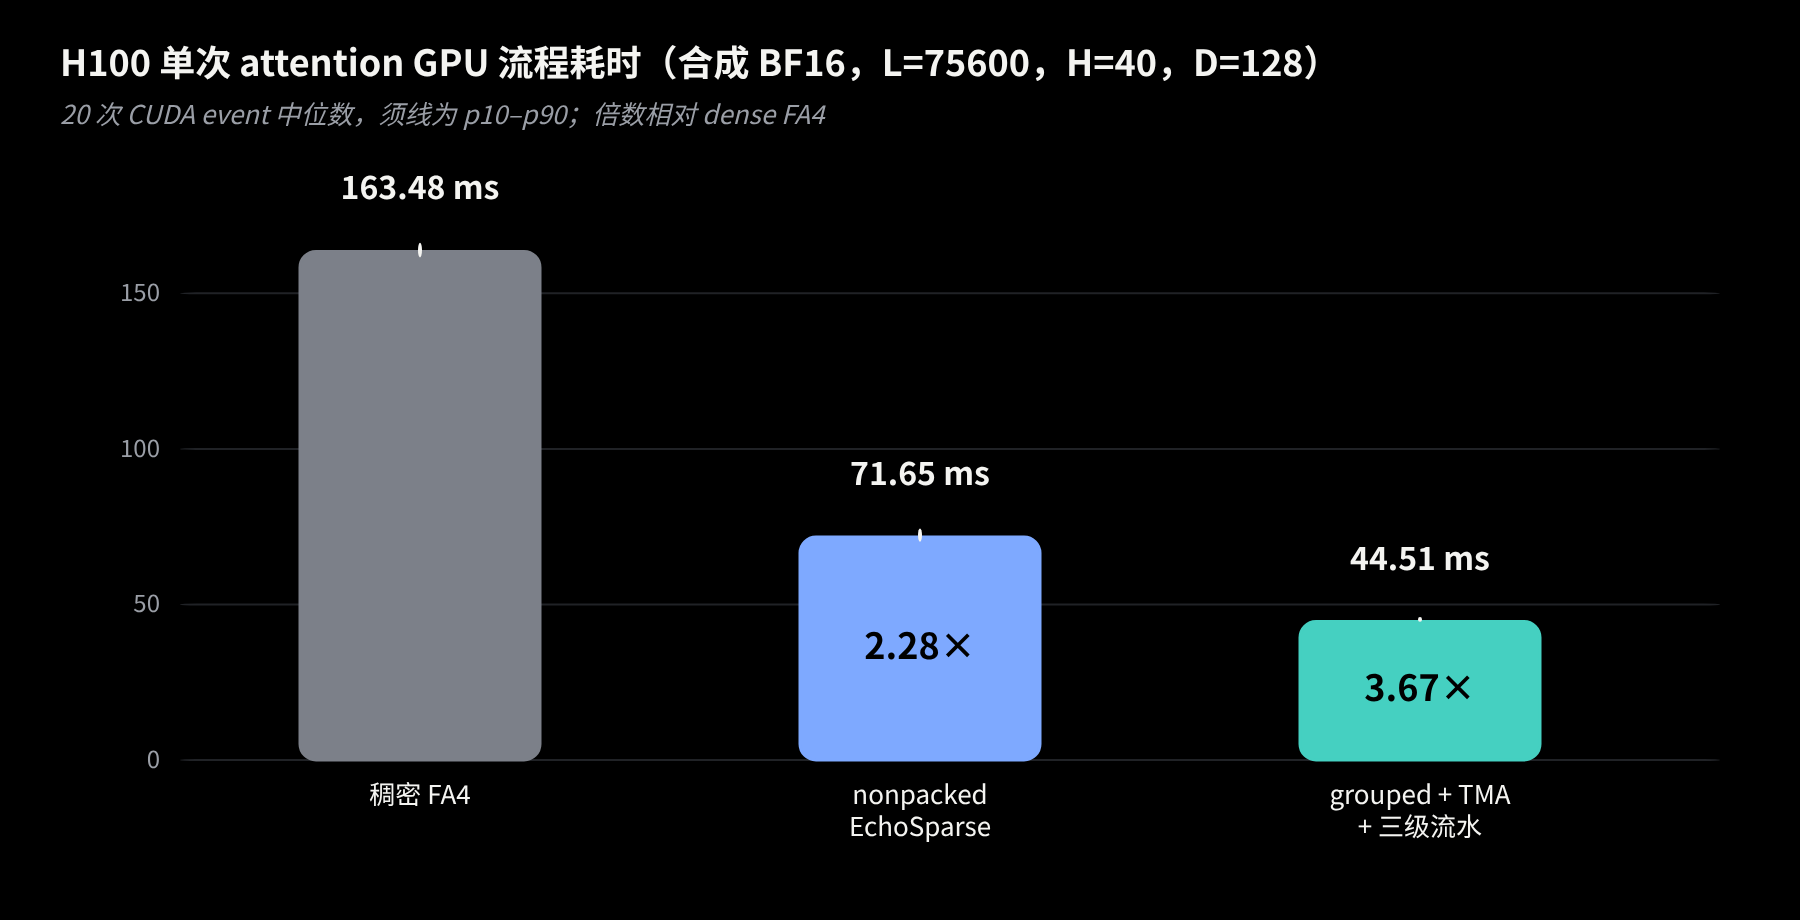
H100 单次 attention(实验分支)
方案
耗时
相对稠密 FA4
相对已发布版
稠密 FlashAttention-4
163.48 ms
1.00×
—
EchoSparse 已发布版(未打包)
71.65 ms
2.28×
1.00×
分组打包 + TMA + 三级流水线(实验分支)
44.51 ms
3.67×
1.61×
输入为合成的 BF16 数据,形状 [B,N,H,D]=[1,75600,40,128],非因果,密度 0.10,计时 20 次取中位数。稀疏方案的计时覆盖整个 GPU 流程,包括代表构造和打包。后两行使用同一份固定的稀疏计划,比较的只是实现方式,1.61× 来自打包和流水线。稠密一行计算全部原始 token,3.67× 中还包含稀疏本身带来的加速。这是单次 attention 的结果,整段视频生成的加速需要另外测量。原始记录:evidence/h100_attention_benchmark.json 。
B200 与 RTX 5090 完整视频生成
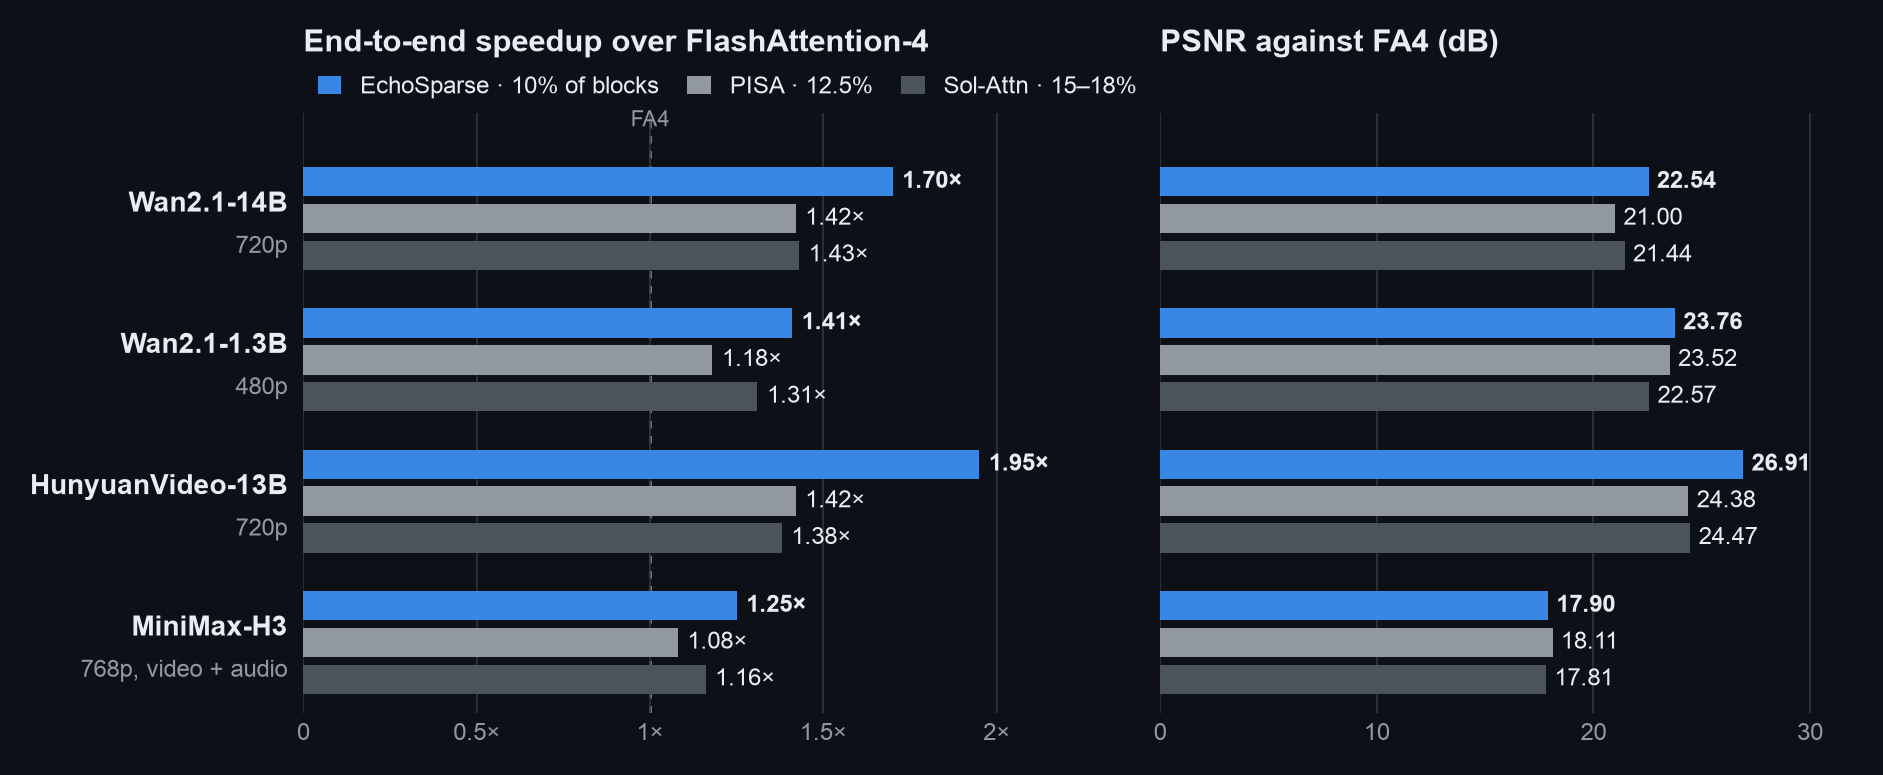
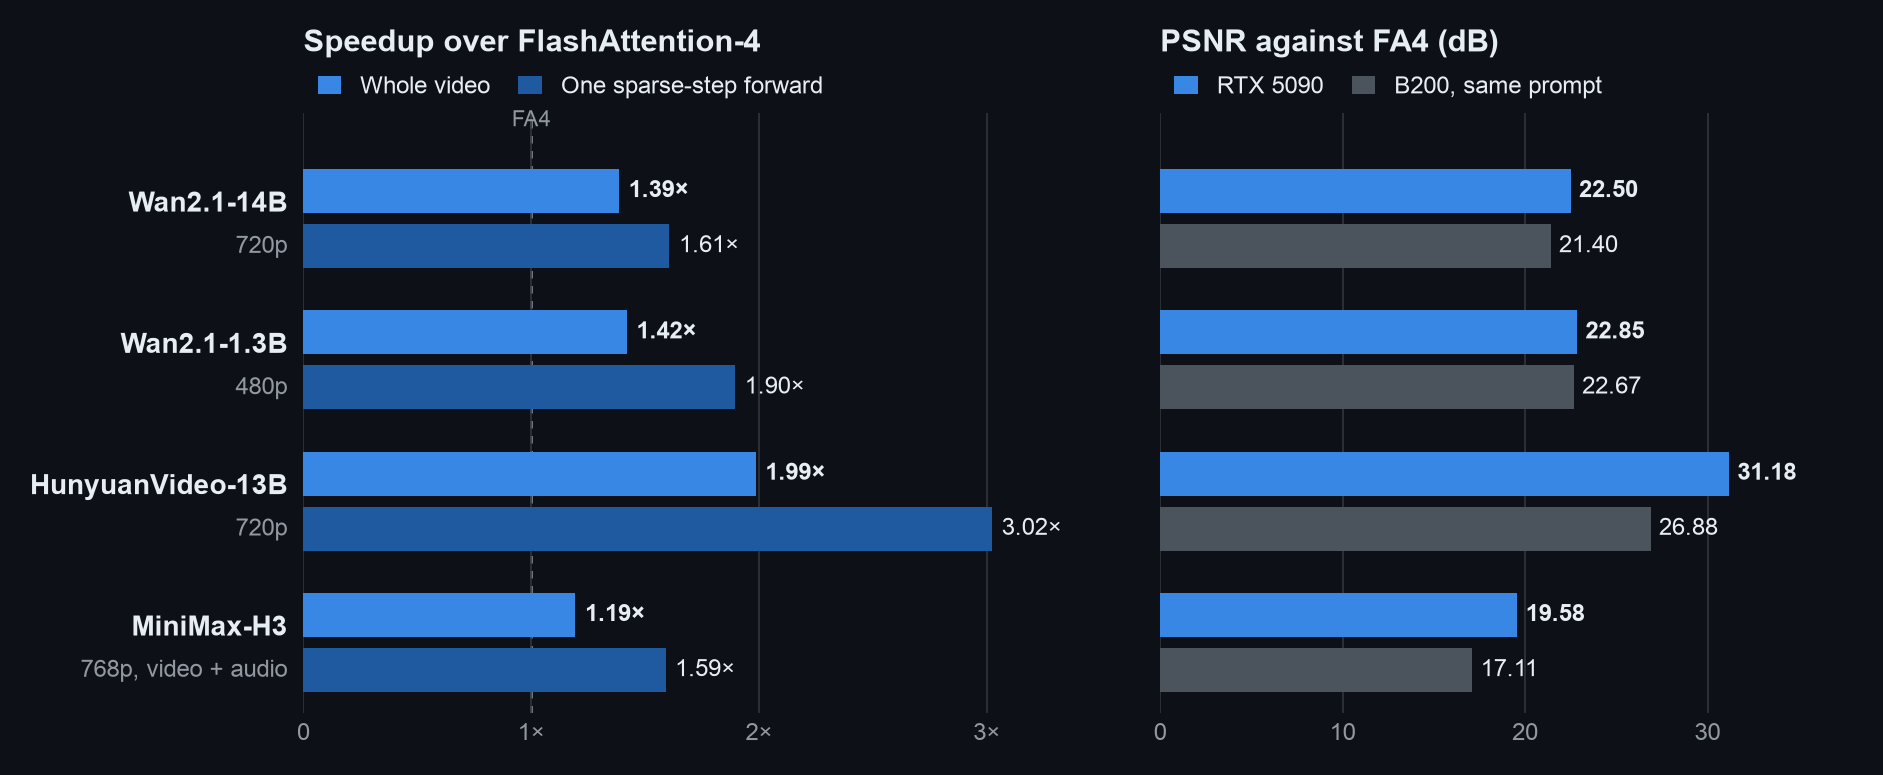
B200 发布结果:50 步完整视频生成,与 Sol-Attn、PISA 对比,PSNR 以稠密 FA4 的输出为参照。 RTX 5090 发布结果:单 GPU,每个模型用一个固定的提示词和 seed 做 50 步生成;右侧 PSNR 旁边列出同一提示词在 B200 上的数值。 Wan2.1-14B 生成整段视频的加速比在 B200 上是 1.70×,在 RTX 5090 上是 1.39×(同一模型单个稀疏步的 forward 为 1.61×)。两组评测的设置不同:RTX 5090 上每个模型只跑了一个提示词;Wan2.1-14B、HunyuanVideo 和 MiniMax-H3 还把权重放在 CPU 内存里,分组搬到 GPU 上计算(CPU offload)。因此这两个数不能直接当作两种硬件的对比。
7. 总结
视频扩散模型中,低权重的 KV 块数量很多,加起来仍会明显影响 softmax 的分子和分母。EchoSparse 用按 token 数加权的代表近似这些块,让它们和精确块留在同一个 softmax 里。1 列、4 列的代表可以拼成完整的 GEMM tile,与精确 token 共用分子和分母,打包前后的计算结果相同。相邻去噪步的 LSE 通常很接近,所以上一步的 LSE 可以作为固定偏移,去掉 online softmax 中求最大值和重缩放的步骤;上一步的块质量则决定每个块用多少代表。
完整的生产者–消费者打包路径还在研究中,尚未实现,也没有发布;H100 与 RTX 4090 的支持也尚未完成。